Java 8 ist da: Lambdas und Streams
Keine Zeit? Hier die Kurzversion in 30 Sekunden.
- Java 8 ist seit dem 18. März verfügbar und bringt Lambdas, Methodenreferenzen, die Stream-API und Default-Methoden.
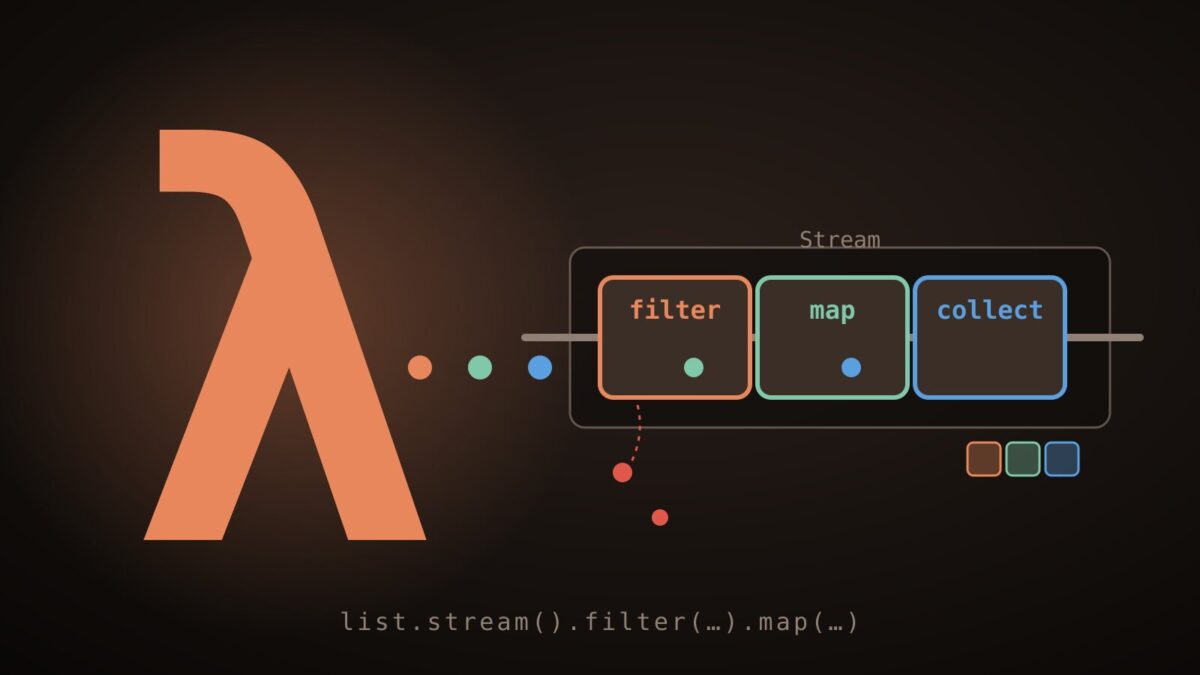
- Aus fünf Zeilen anonymer Klasse wird ein Ausdruck, und Schleifen über Collections lassen sich als Pipeline aus filter, map und collect schreiben.
- Vorsicht bei parallelStream: Es lohnt sich nur bei großen Datenmengen und zustandslosen Operationen.
- Weitere Neuerungen: Nashorn statt Rhino, java.time, und der PermGen weicht dem Metaspace.
- Für mich der größte Sprung seit Java 5, aber im Server-Umfeld braucht der Umstieg Zeit.
Am 18. März ist Java 8 erschienen, und ich habe seitdem mehr Zeit mit dem JDK verbracht als mit allem anderen. Die Erwartungen waren hoch, schließlich wurde Java 8 durch Verschiebungen lange herbeigesehnt. Mein Eindruck nach den ersten Wochen: Es ist der größte Sprung seit Java 5, als Generics und Annotationen dazukamen. Diesmal ändert sich vor allem, wie man Code schreibt.
Lambdas statt anonymer Klassen
Wer ein Sortierkriterium oder einen Callback übergeben wollte, musste bisher eine anonyme Klasse schreiben. Das Beispiel kennt jeder:
// Java 7
Collections.sort(namen, new Comparator<String>() {
    @Override
    public int compare(String a, String b) {
        return a.compareToIgnoreCase(b);
    }
});

// Java 8
Collections.sort(namen, (a, b) -> a.compareToIgnoreCase(b));
Der Compiler leitet die Typen aus dem Kontext ab, übrig bleibt, was wirklich zählt. Ein Lambda ist dabei keine anonyme Klasse in neuer Schreibweise, es ist ein Ausdruck, der zu einem funktionalen Interface passt, also zu einem Interface mit genau einer abstrakten Methode. Das kann Runnable sein, Comparator oder ein eigenes Interface. Neu im Paket java.util.function sind außerdem Standardtypen, die man ständig braucht: Predicate<T> liefert einen Wahrheitswert, Function<T,R> wandelt einen Wert um, Consumer<T> nimmt einen Wert entgegen und gibt nichts zurück.
Dazu kommen Methodenreferenzen, die ich schnell lieb gewonnen habe. String::length ist ein Function<String,Integer>, System.out::println ein Consumer<Object>, und String::isEmpty ein Predicate<String>. Wo ein Lambda nur eine einzige Methode aufruft, ist die Referenz kürzer und lesbarer.
Eine Einschränkung merkt man schnell: Ein Lambda darf lokale Variablen aus der umgebenden Methode lesen, aber nur, wenn sie sich nach der Zuweisung nicht mehr ändern. Der Compiler verlangt das, auch wenn das Schlüsselwort final fehlt. Anfangs nervt das, etwa wenn man in einem Lambda einen Zähler hochzählen möchte. Es zwingt aber dazu, die Sache anders zu lösen, und meistens ist die Lösung ohnehin die bessere.
Streams statt Schleifen
Der zweite große Teil ist die Stream-API. Ein Stream ist keine Datenstruktur, sondern eine Beschreibung einer Verarbeitung: Quelle, dazwischen beliebig viele Zwischenschritte, am Ende eine terminale Operation, die das Ergebnis liefert. Erst dann wird tatsächlich gerechnet. Angenommen, es gibt eine Klasse Kunde mit den Methoden isAktiv(), getName() und getOrt():
// vorher
List<String> namen = new ArrayList<String>();
for (Kunde k : kunden) {
    if (k.isAktiv()) {
        namen.add(k.getName());
    }
}

// nachher
List<String> namen = kunden.stream()
        .filter(Kunde::isAktiv)
        .map(Kunde::getName)
        .collect(Collectors.toList());
Das ist kürzer, aber der eigentliche Gewinn liegt woanders: Man liest, was passiert, und nicht, wie die Schleife es erledigt. Besonders angenehm sind die Collectors. Mit Collectors.groupingBy(Kunde::getOrt) bekommt man eine Map<String, List<Kunde>>, für die ich bisher eine kleine Hilfsmethode samt verschachtelter if-Abfrage geschrieben hätte. Das war zum Beispiel immer so ein Stück Code, das in jedem Projekt neu entstand.
Zwischenschritte wie sorted(), limit() oder distinct() lassen sich ebenso einfügen, und weil die Verarbeitung erst am Ende beginnt, spart sich ein Stream mit limit(10) die Arbeit für alle Elemente danach. Das überrascht, wenn man Schleifen gewohnt ist: Ein map ohne terminale Operation tut schlicht nichts, und wer eine System.out.println-Ausgabe darin vermisst, sucht eine Weile. Außerdem lässt sich ein Stream nur einmal durchlaufen. Wer ihn ein zweites Mal verwenden will, bekommt eine Exception und baut ihn neu aus der Quelle auf.
Dass das bei bestehenden Interfaces überhaupt funktioniert, liegt an den Default-Methoden. Collection.stream() und Iterable.forEach() sind Interface-Methoden mit Implementierung, sonst hätte man jede Collection-Klasse der Welt brechen müssen. Auch für eigene Interfaces ist das nützlich, man kann eine Schnittstelle erweitern, ohne alle Implementierungen anzufassen. Die Kehrseite ist eine Art Mehrfachvererbung von Verhalten, und über die Auflösungsregeln bei Konflikten stolpert man schneller, als man denkt. Sparsam einsetzen.
Vorsicht bei parallelStream
Verlockend ist parallelStream(): Ein Wort ersetzt, und die Verarbeitung verteilt sich auf alle Kerne. So einfach ist es nicht. Der Gewinn stellt sich nur ein, wenn die Datenmenge groß genug ist und die einzelnen Operationen unabhängig voneinander laufen, ohne gemeinsamen veränderlichen Zustand. Wer in einem parallelen Stream in eine normale ArrayList schreibt, produziert Fehler, die man nur sporadisch sieht. Dazu läuft alles im gemeinsamen Fork/Join-Pool, und in einem Server, der ohnehin viele Anfragen gleichzeitig bearbeitet, nimmt man sich damit selbst Rechenzeit weg. Ich würde es erst messen und dann entscheiden, nicht umgekehrt.
Nebenbei dazugekommen
Es gibt mehr, als in einen Artikel passt. Die neue Datum-Zeit-API in java.time löst die leidige Kombination aus Date und Calendar ab, dazu schreibe ich separat noch etwas. Mit Nashorn kommt eine neue JavaScript-Engine, die den alten Rhino ersetzt. Und für alle, die schon einmal einen OutOfMemoryError: PermGen space nach dem x-ten Redeploy gesehen haben: Der PermGen ist weg. Klassenmetadaten liegen jetzt im Metaspace, der im nativen Speicher liegt und von selbst wächst. Ganz ohne Obergrenze würde ich ihn trotzdem nicht betreiben, ein Klassenlader-Leck bleibt ein Leck.
Was jetzt?
Für Neuentwicklungen und Werkzeuge auf dem Desktop kann man sofort umsteigen. Die Entwicklungsumgebungen ziehen nach, an einigen Stellen merkt man noch, dass die Unterstützung frisch ist. Im Server-Umfeld liegt der Fall anders. Mein Eindruck ist, dass die gängigen Application-Server Java 8 noch nicht offiziell freigegeben haben, und solange ein Hersteller das nicht tut, bleibt man im Betrieb besser bei Java 7. Der Umstieg ist eine Sache von Monaten, nicht von Wochen.
Bei Bibliotheken, die andere Projekte benutzen, kommt hinzu, dass man mit Java 8 als Mindestversion auch alle Nutzer zum Umstieg zwingt. Wer Code weitergibt, wird die neuen Sprachmittel deshalb vorerst zurückhaltender verwenden als jemand, der nur für die eigene Laufzeitumgebung schreibt. Das ist bei jedem Versionssprung so, nur wiegt es diesmal schwerer, weil die Neuerungen den Stil des Codes verändern und nicht bloß ein paar Methoden ergänzen.
Ich werde Lambdas und Streams in den nächsten Projekten trotzdem einsetzen, wo es die Umgebung zulässt. Der Code wird kürzer, vor allem aber konzentrierter. Und wer von C# kommt, wird Parallelen zu LINQ erkennen, nur dass Java mit seiner Abwärtskompatibilität einen deutlich weiteren Weg zurücklegen musste. Dass es gelungen ist, ohne alten Code zu brechen, beeindruckt mich fast mehr als die Syntax.
Christian Ackermann
Softwareentwickler (C++, C, Java, C#) aus der Oberpfalz, bloggt seit 2001 über Linux, Technik und Kochen.