KI in der Softwareentwicklung: Chancen, Risiken und wie ihr Code absichert
Kaum ein Thema wird in der Softwareentwicklung gerade so heiß diskutiert wie künstliche Intelligenz. Die einen sehen das Ende des Programmierens, die anderen einen überschätzten Autovervollständiger. Beides stimmt so nicht. Ich arbeite seit über zehn Jahren in der Softwareentwicklung und nutze KI-Werkzeuge inzwischen selbst. In diesem Beitrag fasse ich zusammen, was sie heute leisten, wo sie scheitern und wie man Code, der mit KI entsteht, sauber absichert.
Wo KI in der Entwicklung wirklich hilft
Der größte Gewinn liegt für mich bei Aufgaben, die zeitraubend, aber nicht schwierig sind. Hier spart KI spürbar Zeit:
- Boilerplate und Routinecode: Getter und Setter, Konfigurationen, DTOs, einfache CRUD-Schichten und Skripte entstehen in Sekunden.
- Tests schreiben: Zu einer bestehenden Funktion lassen sich schnell Testfälle samt Grenzwerten vorschlagen. Das senkt die Hürde, überhaupt Tests zu schreiben.
- Code erklären: Bei fremdem oder altem Code liefert KI eine erste Orientierung. Gerade bei Legacy-Projekten ohne Dokumentation ist das Gold wert.
- Refactoring und Migration: Umbenennen, Aufteilen, Umstellen auf neuere Sprachstandards oder Bibliotheken. Die Routinearbeit übernimmt die Maschine, die Entscheidungen bleiben beim Menschen.
- Dokumentation und Commit-Texte: Kommentare, Changelogs und Beschreibungen sind schnell entworfen.
- Fehlersuche: Eine Fehlermeldung oder ein Stacktrace plus der betroffene Code führen oft schneller zur Ursache als die Suche in Foren.
- Lernen und Prototypen: Eine neue Sprache oder ein Framework lässt sich über Beispiele im Dialog deutlich schneller erschließen.
Dazu kommt ein weicher Faktor: Man kommt schneller ins Tun. Die leere Datei verliert ihren Schrecken, wenn es einen ersten Entwurf gibt, den man verbessern kann.
Was KI heute schon kann und was nicht
Moderne Modelle schreiben in gängigen Sprachen wie Java, C#, C++, Python, JavaScript oder PHP erstaunlich brauchbaren Code. Agentenbasierte Werkzeuge können mehrere Dateien lesen, Befehle ausführen, Tests starten und sich an den Ergebnissen orientieren. Bei klar umrissenen Aufgaben in überschaubarem Umfang funktioniert das oft gut.
Die Grenzen zeigen sich dort, wo es nicht mehr um Syntax geht, sondern um Verständnis:
- Fachlichkeit und Kontext: Die KI kennt weder eure Geschäftsregeln noch die Geschichte eines gewachsenen Systems. Was nicht im Prompt oder im Code steht, rät sie.
- Architektur: Einzelne Funktionen gelingen, ein tragfähiges Gesamtdesign ist etwas anderes. Ohne Führung entstehen schnell Duplikate und uneinheitliche Muster.
- Verantwortung: Eine KI haftet nicht. Wer den Code übernimmt, trägt das Ergebnis, auch gegenüber Kunden und Auftraggebern.
- Sicherheit und Randfälle: Der Code sieht oft plausibel aus und läuft im Normalfall. Die Probleme stecken in leeren Eingaben, Nebenläufigkeit, Zeitzonen, Rundung oder Berechtigungen.
- Eigene Fehler erkennen: Modelle klingen sicher, auch wenn sie falsch liegen. Sie erfinden gelegentlich Funktionen, Parameter oder ganze Bibliotheken, die es nicht gibt.
- Große, verwobene Systeme: Je größer und älter der Code, desto häufiger gehen Zusammenhänge verloren, die ein Mensch mit Systemkenntnis sofort sieht.
Mein Eindruck: KI ist ein sehr schneller, sehr belesener Junior. Er liefert zügig, übersieht aber Zusammenhänge und gibt selten zu, etwas nicht zu wissen. Genau so sollte man seine Arbeit auch behandeln.
Die Risiken im Überblick
Sicherheitslücken im generierten Code
KI lernt aus vorhandenem Code, und der enthält viele Altlasten. Klassiker sind SQL-Injection, fehlende Eingabevalidierung, unsichere Standardeinstellungen, veraltete Kryptografie oder zu großzügige Rechte. Ein typisches Beispiel in PHP:
// Vorschlag, der funktioniert, aber angreifbar ist
$sql = "SELECT * FROM users WHERE email = '" . $_POST['email'] . "'";

// So gehört es sich: Prepared Statement
$stmt = $pdo->prepare('SELECT * FROM users WHERE email = :email');
$stmt->execute(['email' => $_POST['email']]);
Beide Varianten liefern im Test dasselbe Ergebnis. Nur eine davon ist sicher. Deshalb reicht „es läuft“ als Abnahmekriterium nie aus.
Erfundene Pakete und Supply-Chain-Risiken
Schlägt die KI eine Bibliothek vor, die es nicht gibt, kann ein Angreifer genau diesen Namen registrieren und Schadcode hinterlegen. Pakete, die ihr nicht kennt, prüft ihr vor der Installation: Herkunft, Pflegezustand, Lizenz, Verbreitung.
Datenschutz und Geheimnisse
Was in einen Cloud-Dienst eingegeben wird, verlässt das Haus. Quellcode, Zugangsdaten, API-Schlüssel, Kundendaten und Interna gehören nicht ungeprüft in einen Prompt. Dazu zählen auch Dateien, die ein Agent selbstständig liest. In Unternehmen braucht es klare Regeln, einen Vertrag mit dem Anbieter (inklusive Auftragsverarbeitung, wenn personenbezogene Daten im Spiel sein können) und idealerweise freigegebene Werkzeuge statt Wildwuchs.
Lizenzen und Urheberrecht
Generierter Code kann Mustern aus lizenzierten Projekten ähneln. Die Rechtslage ist teilweise noch offen. Wer kommerziell arbeitet, sollte Anbieterbedingungen lesen, Herkunftsfilter nutzen, wo es sie gibt, und bei größeren Übernahmen eine Prüfung einplanen.
Schleichende Qualitätsprobleme
KI macht es leicht, viel Code zu erzeugen. Mehr Code heißt aber auch mehr Wartung. Wenn niemand den Code wirklich versteht, entstehen technische Schulden in Rekordzeit. Und wer nur noch abnickt, verlernt mit der Zeit das, was er zum Prüfen braucht.
So sichert ihr KI-Code ab und gewährleistet Qualität
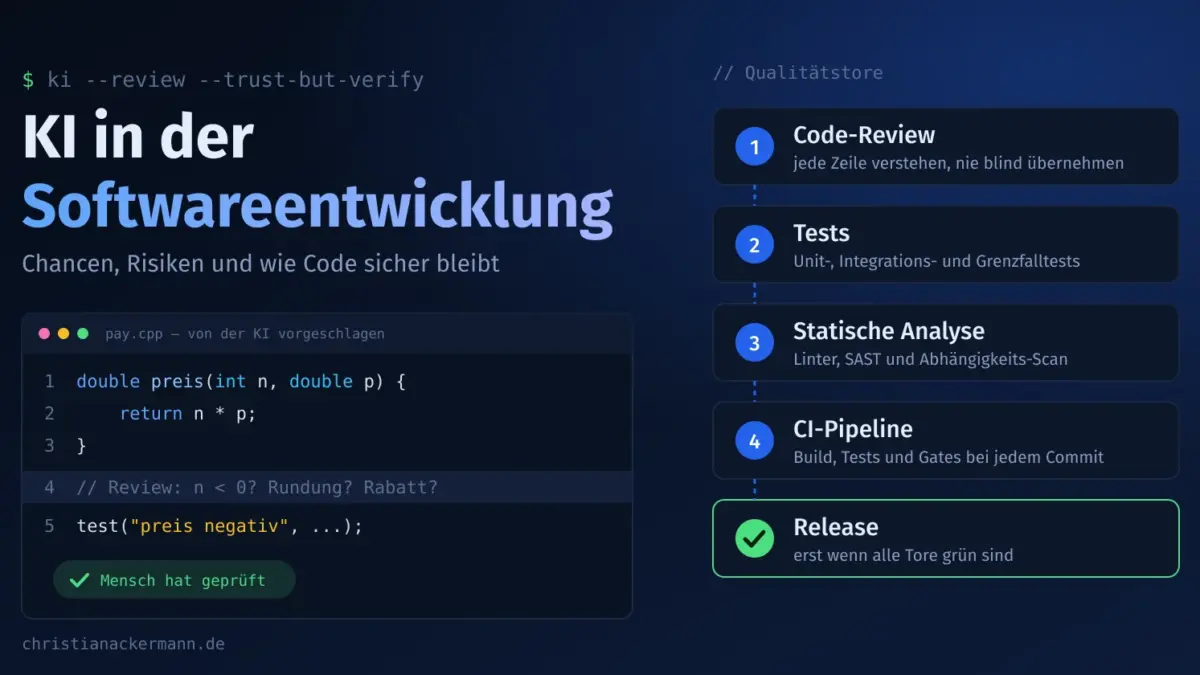
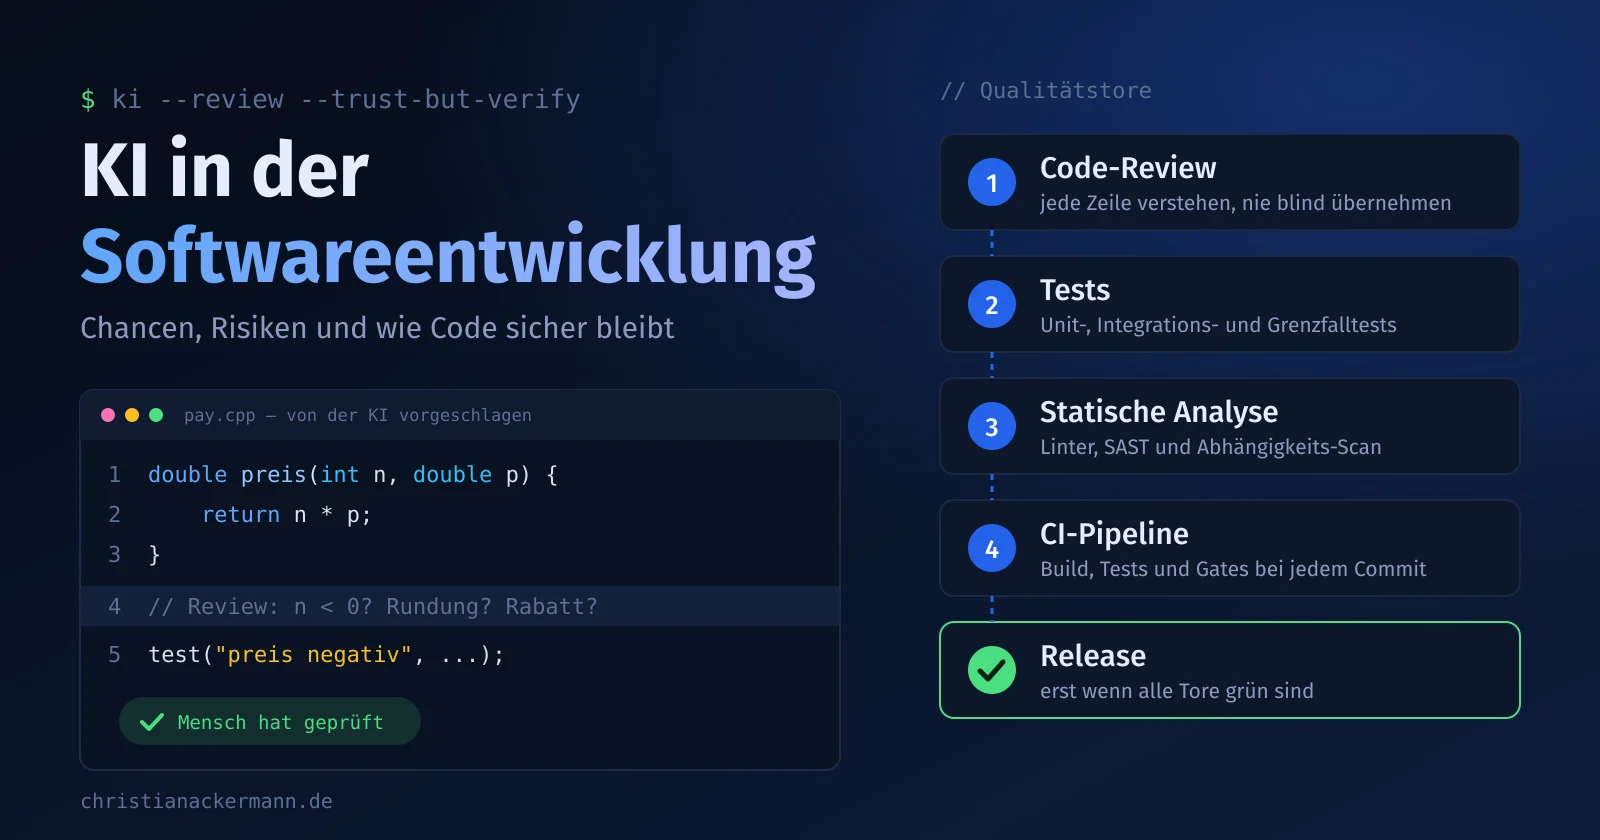
Die gute Nachricht: Wer ohnehin sauber arbeitet, braucht dafür kaum neue Methoden. Es gelten dieselben Regeln wie für jeden anderen Code, nur konsequenter. Meine Checkliste:
- Verstehen, bevor ihr übernehmt. Jede Zeile, die ihr einchecken würdet, müsst ihr erklären können. Was ihr nicht versteht, geht nicht in den Hauptzweig.
- Review wie bei einem Kollegen. KI-Code läuft durch dasselbe Vier-Augen-Prinzip wie alles andere. Pull Requests klein halten, damit sich tatsächlich jemand die Mühe macht.
- Tests als Sicherheitsnetz. Unit- und Integrationstests, dazu Grenzfälle und Fehlerpfade. Schreibt die Tests im Zweifel zuerst oder lasst sie getrennt vom Code prüfen, damit nicht eine KI ihre eigenen Annahmen bestätigt. Lasst euch außerdem die Testabdeckung und, wo möglich, Mutationstests zeigen.
- Statische Analyse und Linter. Werkzeuge wie SonarQube, clang-tidy, SpotBugs, PHPStan oder ESLint finden Muster, die im Review leicht durchrutschen. SAST-Scanner (zum Beispiel Semgrep oder CodeQL) suchen gezielt nach Sicherheitsproblemen.
- Abhängigkeiten prüfen. Dependency-Scans und eine Software-Stückliste (SBOM) zeigen bekannte Schwachstellen und Lizenzen. Versionen fixieren, neue Pakete bewusst freigeben.
- Geheimnisse konsequent fernhalten. Secret-Scanner im Repository und in der Pipeline, Schlüssel nie im Code, Zugangsdaten für Agenten auf das Nötigste beschränken.
- Alles durch die CI-Pipeline. Build, Tests, Analyse und Scans laufen bei jedem Commit automatisch (zum Beispiel mit Jenkins). Schlägt ein Tor fehl, wird nicht ausgeliefert. Das gilt für KI-Code und menschlichen Code gleichermaßen.
- Klare Vorgaben im Prompt. Nennt Sprache, Version, Coding-Standards, Fehlerbehandlung und Sicherheitsanforderungen. Gute Vorgaben ersparen schlechte Entwürfe, ersetzen aber nie die Prüfung.
- Kleine Schritte, keine Großaufträge. Lieber viele überschaubare Änderungen, die sich prüfen lassen, als ein Block mit tausend Zeilen. Agenten arbeiten am besten in isolierten Zweigen, nicht direkt auf Produktivsystemen.
- Regeln im Team festhalten. Wo darf KI eingesetzt werden, welche Daten dürfen hinein, wie wird gekennzeichnet und geprüft? Das gehört in eine kurze, verbindliche Richtlinie.
- Wissen erhalten. Verstehen bleibt Handwerk. Wer KI nutzt, sollte weiter selbst programmieren, Fehler selbst suchen und Architekturentscheidungen selbst treffen.
Mein Fazit
KI verändert die Softwareentwicklung, aber sie ersetzt nicht die Verantwortung. Sie nimmt uns Tipparbeit ab und gibt Raum für das, was wirklich zählt: Anforderungen verstehen, Architektur entscheiden, Qualität sicherstellen. Wer sie als Werkzeug mit klaren Leitplanken einsetzt, wird schneller und bleibt dabei sicher. Wer ungeprüft übernimmt, kauft sich Probleme ein, die später teuer werden.
Mein Grundsatz lautet deshalb: vertrauen, aber prüfen. Und die Prüfung gehört nicht ans Ende, sondern in den Prozess, mit Review, Tests, Analyse und Pipeline. Wie setzt ihr KI in der Entwicklung ein? Und welche Regeln gelten bei euch? Schreibt mir gern auf LinkedIn.
Christian Ackermann
Softwareentwickler (C++, C, Java, C#) aus der Oberpfalz, bloggt seit 2001 über Linux, Technik und Kochen.