Kleine Modelle, große Fragen: Warum nicht jede Aufgabe das größte KI-Modell braucht
Keine Zeit? Hier die Kurzversion in 30 Sekunden.
- Nicht jede Aufgabe braucht das größte KI-Modell. Für Logs, SQL, Datenmapping oder Tickets reichen oft kleine, spezialisierte Modelle.
- Sie sind schneller, günstiger, lassen sich lokal betreiben und sind leichter zu kontrollieren.
- Eigener Betrieb heißt aber auch eigene Arbeit, viele Teams setzen deshalb auf hybride Lösungen.
- Gegen Shadow AI helfen gute offizielle Werkzeuge mehr als Verbote.
- Der EU AI Act verlangt vor allem Überblick und Nachvollziehbarkeit, und das gelingt mit kleinen Modellen leichter.
Eine Zeit lang schien die Entwicklung bei KI nur eine Richtung zu kennen: größer. Mehr Parameter, mehr Trainingsdaten, mehr Rechenleistung. Jedes neue Modell konnte mehr als das vorherige, und die naheliegende Schlussfolgerung war, dass man für jede Aufgabe einfach das stärkste verfügbare Modell nimmt.
Inzwischen hat sich der Blick in vielen Teams verändert. Nicht, weil die großen Modelle schlechter geworden wären, im Gegenteil. Sondern weil man angefangen hat, nüchterner zu rechnen. Was kostet das eigentlich? Wie lange dauert eine Antwort? Wo landen unsere Daten? Und brauchen wir für diese eine Aufgabe wirklich ein Modell, das auch Gedichte schreiben und Philosophie diskutieren kann?
Das Werkzeug zur Aufgabe passend wählen
Man nimmt keinen Kran, um ein Bild aufzuhängen. Diese Logik setzt sich auch bei KI durch.
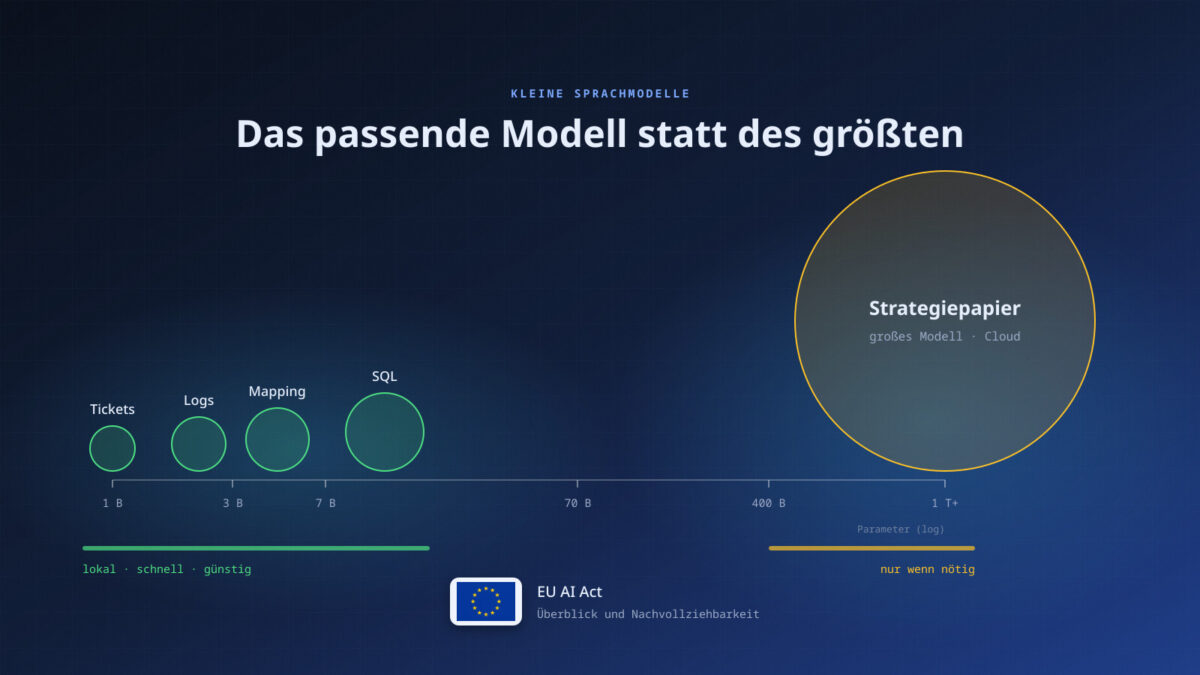
Es gibt sehr viele Aufgaben in der IT, die klar umrissen sind. Logdateien nach bestimmten Mustern durchsuchen. Aus einer natürlichsprachlichen Frage eine SQL-Abfrage bauen. Datenfelder von einem Format in ein anderes übersetzen. Tickets nach Kategorien sortieren. Für solche Dinge braucht man kein Universalgenie. Man braucht ein Modell, das genau diese eine Sache zuverlässig kann.
Hier kommen sogenannte Small Language Models ins Spiel, kleinere Sprachmodelle, die oft gezielt auf einen Bereich zugeschnitten oder nachtrainiert werden. Sie haben ein paar handfeste Vorteile:
- Sie sind schneller, weil weniger gerechnet werden muss.
- Sie sind günstiger im Betrieb, oft um ein Vielfaches.
- Sie lassen sich lokal oder auf eigener Infrastruktur betreiben, ohne dass Daten das Haus verlassen.
- Ihr Verhalten ist leichter zu überblicken, weil der Aufgabenbereich enger ist.
Ich merke den Effekt selbst, wenn auch in kleinerem Maßstab. Wenn ich mit Claude Code arbeite, lasse ich einfache Teilaufgaben wie das Suchen und Zusammenfassen von Dateien gern von einem kleineren Modell erledigen. Planung und Entscheidungen bleiben beim großen. Das Ergebnis ist kaum schlechter, aber deutlich günstiger. Im Unternehmenskontext, wo solche Aufgaben tausendfach am Tag anfallen, ist dieser Unterschied enorm.
Der Reiz der Unabhängigkeit
Neben den Kosten gibt es ein zweites Argument, das in Europa besonders laut diskutiert wird: digitale Souveränität.
Wer seine KI-Funktionen vollständig über einen externen Anbieter bezieht, macht sich abhängig. Von dessen Preisen, dessen Verfügbarkeit, dessen Nutzungsbedingungen und letztlich auch von den rechtlichen Rahmenbedingungen in dem Land, in dem er sitzt. Das ist nicht automatisch schlecht. Wir sind auch bei vielen anderen Diensten von Anbietern abhängig. Aber bei KI ist die Abhängigkeit besonders tief, weil oft sensible Daten durch diese Systeme laufen.
Ein Modell, das auf eigenen Servern läuft, ändert diese Gleichung. Man weiß, wo die Daten sind. Man kann das Modell einfrieren und sicher sein, dass es sich morgen genauso verhält wie heute. Man ist nicht betroffen, wenn ein Anbieter sein Angebot umstellt oder ein älteres Modell abschaltet.
Allerdings sollte man sich keine Illusionen machen. Ein eigenes Modell zu betreiben bedeutet auch, sich um alles selbst zu kümmern: Hardware, Updates, Sicherheit, Überwachung, Qualitätssicherung. Das ist Arbeit, und sie verschwindet nicht, nur weil man sie nicht mehr an einen Anbieter zahlt. Viele Teams landen deshalb bei hybriden Ansätzen. Sensible und standardisierte Aufgaben laufen lokal, für die wirklich schwierigen Fälle greift man auf die großen Modelle zurück.
Shadow AI: Das Problem, über das ungern gesprochen wird
Ein Thema, das IT-Leitungen gerade spürbar umtreibt, ist die sogenannte Shadow AI. Gemeint ist die unkontrollierte Nutzung von KI-Diensten durch Mitarbeitende, an der IT vorbei.
Das passiert selten aus böser Absicht. Jemand hat eine lange E-Mail zusammenzufassen, einen Vertrag zu prüfen oder ein Stück Code zu debuggen. Der offizielle Weg ist umständlich oder gar nicht vorhanden, also kopiert man den Text eben schnell in einen öffentlichen Chatbot. Es geht ja schneller.
Das Problem ist, dass dabei Daten das Unternehmen verlassen, ohne dass jemand weiß, wohin. Kundendaten, interne Strategiepapiere, Quellcode, Zugangsdaten, die versehentlich in einem Log stehen. Je nach Dienst und Einstellungen können diese Daten gespeichert, ausgewertet oder sogar zum Training weiterer Modelle verwendet werden. Und selbst wenn nicht, hat das Unternehmen die Kontrolle darüber verloren.
Ich halte es für einen Fehler, darauf nur mit Verboten zu reagieren. Verbote führen meistens dazu, dass die Nutzung einfach heimlicher wird. Viel wirksamer ist es, eine gute, offizielle Alternative anzubieten. Wenn Mitarbeitende ein KI-Werkzeug haben, das genauso bequem ist wie der öffentliche Chatbot, aber unter kontrollierten Bedingungen läuft, verschwindet ein großer Teil der Schatten-Nutzung von allein. Dazu gehören klare Regeln, welche Daten wo verarbeitet werden dürfen, und eine Kultur, in der man nachfragen kann, ohne sich dafür rechtfertigen zu müssen.
Der EU AI Act und die Frage der Nachvollziehbarkeit
Mit dem EU AI Act gibt es inzwischen auch einen rechtlichen Rahmen, der viele dieser Fragen nicht mehr freiwillig macht. Die Verordnung ist 2024 in Kraft getreten, ihre Pflichten greifen gestaffelt über mehrere Jahre. Sie unterscheidet KI-Systeme nach ihrem Risiko und stellt je nach Einstufung unterschiedliche Anforderungen.
Für viele Unternehmen bedeutet das vor allem eines: Sie müssen wissen, wo sie überhaupt KI einsetzen. Das klingt trivial, ist es aber nicht, gerade wenn Shadow AI im Spiel ist. Darüber hinaus geht es um Dokumentation, um Transparenz gegenüber Betroffenen und, je nach Anwendungsfall, um Nachvollziehbarkeit. Welche Daten wurden verwendet? Welches Modell hat welche Entscheidung getroffen? Lässt sich ein Ergebnis im Nachhinein erklären?
Hier haben kleinere, spezialisierte Modelle einen strukturellen Vorteil. Je enger der Aufgabenbereich und je kontrollierter die Umgebung, desto leichter lässt sich dokumentieren, was passiert. Man kann Eingaben und Ausgaben protokollieren, Versionen festhalten und Tests definieren, die das Verhalten des Modells regelmäßig prüfen. Bei einem riesigen Universalmodell, das über eine externe Schnittstelle angesprochen wird und sich jederzeit ändern kann, ist das deutlich schwieriger.
Ich bin kein Jurist und will hier keine Rechtsberatung geben. Wer KI in sensiblen Bereichen einsetzt, sollte sich unbedingt fachkundig beraten lassen, welche Pflichten konkret gelten. Aber unabhängig von der Rechtslage halte ich Nachvollziehbarkeit für gute Praxis. Ein System, dessen Entscheidungen man nicht erklären kann, sollte man in wichtigen Prozessen ohnehin nicht einsetzen.
Pragmatismus statt Euphorie
Was mir an der aktuellen Entwicklung gefällt, ist der Wechsel von Begeisterung zu Pragmatismus. Die Frage ist nicht mehr, welches Modell das beeindruckendste ist, sondern welches für eine bestimmte Aufgabe am besten passt. Das ist eine erwachsenere Haltung.
Für die meisten Teams wird die Antwort keine Entweder-oder-Entscheidung sein. Große Frontier-Modelle haben ihren Platz, wenn es um komplexes Denken, offene Fragen oder kreative Aufgaben geht. Kleine, spezialisierte Modelle übernehmen die vielen klar definierten Routineaufgaben, schneller, günstiger und unter eigener Kontrolle. Und über allem steht die Frage, wo welche Daten verarbeitet werden dürfen.
Wer diese Fragen sauber beantwortet, hat am Ende nicht nur eine günstigere KI-Landschaft, sondern auch eine, der man vertrauen kann. Und darauf kommt es an, wenn KI nicht mehr nur ein Experiment ist, sondern ein fester Bestandteil der täglichen Arbeit.
Beitragsbild: eigene Grafik mit der Flagge Europas (gemeinfrei, Quelle: Wikimedia Commons).

Christian Ackermann
Softwareentwickler (C++, C, Java, C#) aus der Oberpfalz, bloggt seit 2001 über Linux, Technik und Kochen.