Schneller Code, langsames Review: Was KI-Assistenten mit unserer Codequalität machen
Keine Zeit? Hier die Kurzversion in 30 Sekunden.
- KI-Code sieht fast immer ordentlich aus, gerade deshalb fallen technische Schulden kaum auf.
- Wenn Code in Minuten entsteht, wird das Review zum Engpass. Werkzeuge mit Blick auf das ganze Repository helfen, brauchen aber klare Konventionen.
- Ich prüfe trotz KI-Reviews jede Zeile selbst. Was ich nicht verstehe, kommt nicht rein.
- Ein vollautomatischer Review- und Freigabeprozess kann nicht das Ziel sein, selbst wenn die KI ähnlich gut prüft wie ein Mensch.
- Feingefühl, subjektive Einschätzung und vor allem die Verantwortung für eine Freigabe bleiben beim Menschen.
Es gibt einen Moment, den viele kennen, die täglich mit KI-Assistenten programmieren. Man beschreibt eine Funktion, drückt Enter, und Sekunden später steht da ein sauber formatierter Block Code, der genau das tut, was man wollte. Vielleicht sogar mit Kommentaren und einem passenden Test. Das ist ein gutes Gefühl.
Und dann, ein paar Wochen später, sitzt man vor demselben Code und fragt sich, warum er eigentlich so aussieht. Warum es drei Hilfsfunktionen gibt, die fast dasselbe tun. Warum an einer Stelle ein ganz anderer Stil verwendet wurde als im Rest des Projekts. Warum ein Fehlerfall abgefangen wird, der gar nicht auftreten kann, während ein anderer, sehr realer, einfach durchrutscht.
Ich arbeite selbst viel mit Claude Code, und ich nutze die Unterstützung gern. Ohne sie würde ich heute deutlich langsamer vorankommen, das gebe ich offen zu. Aber je länger ich damit arbeite, desto deutlicher wird mir: Die Frage ist nicht, ob KI guten Code schreiben kann. Das kann sie, oft sogar erstaunlich gut. Die Frage ist, was mit einem Projekt passiert, wenn Code viel schneller entsteht, als Menschen ihn verstehen können. Und wer am Ende dafür geradesteht.
Um diese zweite Frage geht es mir in diesem Beitrag besonders. Denn ich habe für mich eine klare Antwort gefunden, und die lautet: Das Review gebe ich nicht ab. Nie ganz.
Die stille Schuld
Technische Schulden sind nichts Neues. Jedes Projekt sammelt sie an, durch Zeitdruck, durch Abkürzungen, durch Entscheidungen, die damals sinnvoll waren und heute nicht mehr passen. Neu ist die Art, wie sie entstehen.
Früher war schlechter Code meistens als solcher zu erkennen. Er war unordentlich, schlecht benannt, voller auskommentierter Reste. Man sah ihm an, dass jemand unter Druck stand oder gerade keine Lust mehr hatte. KI-generierter Code dagegen sieht fast immer ordentlich aus. Er ist gut formatiert, die Variablennamen sind sinnvoll, es gibt Kommentare. Er wirkt professionell, auch dann, wenn er inhaltlich danebenliegt.
Genau das macht ihn tückisch. Die Schulden sind nicht mehr laut, sie sind leise. Sie verstecken sich in Duplikaten, die man nicht bemerkt, weil sie leicht unterschiedlich formuliert sind. In Abstraktionen, die nicht zur bestehenden Architektur passen. In Lösungen, die für sich genommen funktionieren, aber das Gesamtsystem ein kleines Stück unübersichtlicher machen. Jede einzelne Änderung ist harmlos. In der Summe wird das Projekt zäh.
Dazu kommt ein psychologischer Effekt, den ich bei mir selbst beobachte. Ordentlich aussehender Code erzeugt Vertrauen. Wenn etwas sauber eingerückt und schön kommentiert ist, liest man es mit weniger Misstrauen. Das ist bei menschlichem Code übrigens genauso, nur dass Menschen nicht in einer Minute zweihundert Zeilen davon produzieren.
Kontext ist alles
Ein großer Teil dieses Problems hat mit Kontext zu tun. Die ersten Code-Assistenten haben im Grunde geraten. Sie sahen ein paar Zeilen um den Cursor herum und haben vorhergesagt, was wahrscheinlich als Nächstes kommt. Das war erstaunlich gut für kleine Dinge, aber sie wussten nichts über den Rest des Projekts.
Das ändert sich gerade. Moderne Werkzeuge arbeiten mit einem deutlich tieferen Verständnis der gesamten Codebasis. Man spricht inzwischen gern von „Repository Intelligence“. Gemeint ist, dass das Werkzeug nicht nur die aktuelle Datei kennt, sondern die Struktur des Projekts, die vorhandenen Schnittstellen, die Konventionen, die Abhängigkeiten. Es kann nachsehen, ob es eine passende Hilfsfunktion schon gibt, bevor es eine neue schreibt.
Das ist ein echter Fortschritt, und ich merke ihn im Alltag. Ein Agent, der erst einmal sucht und liest, bevor er schreibt, liefert spürbar bessere Ergebnisse als einer, der sofort loslegt. Aber auch hier gilt: Das Werkzeug kann nur so gut sein wie das, was es vorfindet. Wenn ein Projekt keine klaren Konventionen hat, kann auch die beste KI sie nicht erraten. Sie wird dann eben den Stil übernehmen, den sie zuerst findet, oder einen eigenen erfinden.
Für mich folgt daraus etwas, das zunächst paradox klingt: Je mehr KI im Projekt mitarbeitet, desto wichtiger wird gute, explizite Dokumentation. Nicht für Menschen allein, sondern auch für die Maschine. Eine Datei, in der steht, wie das Projekt aufgebaut ist, welche Muster verwendet werden und welche nicht, ist plötzlich enorm wertvoll. Wer sie pflegt, bekommt besseren Code. Und wer sie im Review im Kopf hat, erkennt schneller, wenn etwas aus der Reihe tanzt.
Der Flaschenhals wandert
Hier kommt der Punkt, der mich am meisten beschäftigt. Wenn Code deutlich schneller geschrieben wird, verschwindet die Arbeit nicht. Sie verlagert sich.
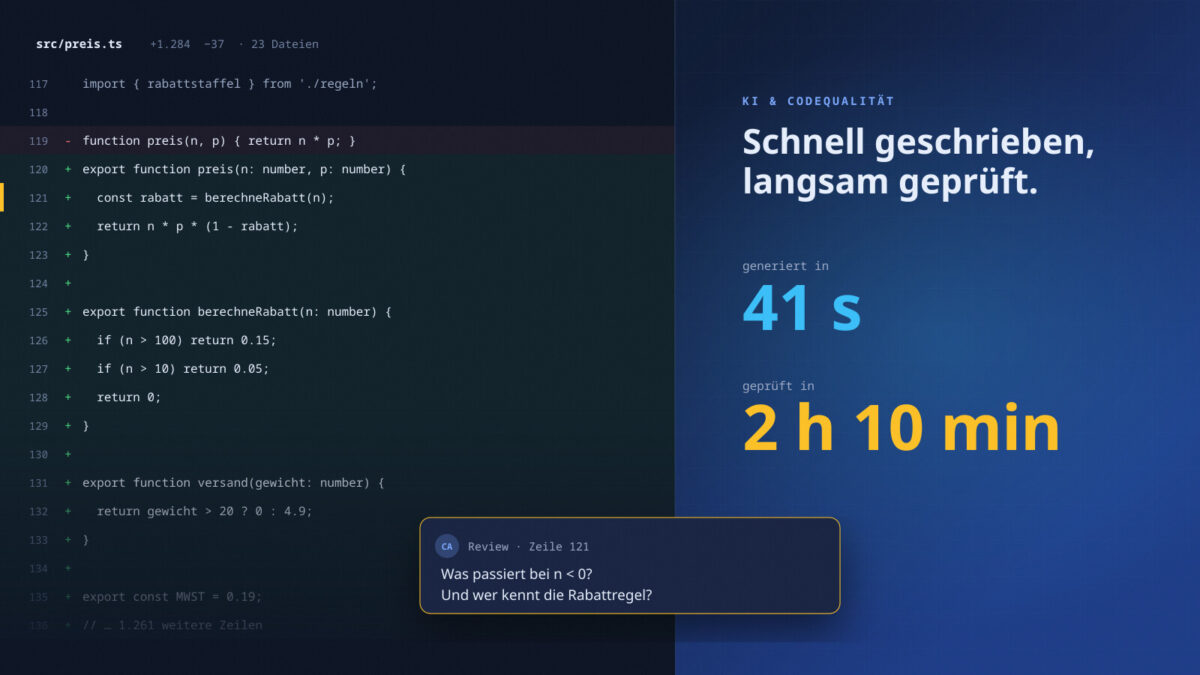
Früher war das Schreiben selbst oft der langsamste Teil. Ein Entwickler brauchte einen Tag für ein Feature, und das Review dauerte vielleicht eine Stunde. Das Verhältnis war erträglich. Wenn das Feature jetzt in einer Stunde geschrieben ist, das Review aber immer noch eine Stunde braucht, hat sich das Verhältnis komplett gedreht. Und wenn der Code in größeren Mengen kommt, weil er so billig zu erzeugen ist, dann wird das Review zum Engpass.
Ich kenne die Versuchung gut. Ein großer Block generierter Code, der ordentlich aussieht, die Tests laufen grün, die KI-Prüfung hat nichts gefunden. Was soll da schon sein? Man könnte das jetzt einfach durchwinken und weitermachen. Genau so entsteht die stille Schuld, von der ich oben geschrieben habe.
Ein gutes Review war schon immer anstrengend. Man muss den Code nicht nur lesen, sondern verstehen, warum er so ist, wie er ist, und ob das zur Absicht passt. Bei generiertem Code fehlt oft die Absicht, die man sonst vom Autor erfragen könnte. Man kann die KI zwar fragen, warum sie etwas so gemacht hat. Aber die Antwort ist eine nachträgliche Begründung und keine echte Erinnerung an eine Entscheidung. Sie klingt plausibel, und das ist schon alles, was man über sie sicher sagen kann.
Wie ich selbst reviewe: jede Zeile
Deshalb habe ich mir eine Regel gesetzt, von der ich nicht abweiche. Ich prüfe jede Zeile, die in eines meiner Projekte wandert. Egal, ob ich sie selbst getippt habe, ob Claude sie geschrieben hat oder ob vorher schon eine KI-Prüfung drübergelaufen ist und nichts gefunden hat.
Das klingt nach viel Aufwand, und das ist es auch. Aber es ist der Preis dafür, dass ich hinterher weiß, was in meinem Code steckt. Nicht ungefähr, nicht „die Tests sind ja grün“, sondern wirklich. Wenn ich einen Commit abschließe, bin ich mir sicher, was übernommen wird und warum.
Wie das konkret aussieht, ist gar nicht so spektakulär. Ich lese den Diff von oben nach unten, ohne zu springen. Bei jeder Änderung frage ich mich, ob ich das selbst so geschrieben hätte. Wenn nicht, will ich wissen, warum es so ist. Manchmal ist die Lösung der KI besser als meine eigene Idee, dann lerne ich etwas. Manchmal ist sie einfach anders, dann passe ich sie an den Rest des Projekts an. Und manchmal ist sie falsch, obwohl sie richtig aussieht. Das sind genau die Stellen, für die sich der ganze Aufwand lohnt.
Was ich nicht verstehe, kommt nicht rein. Das ist vielleicht die wichtigste Regel von allen. Wenn ich eine Zeile nicht erklären kann, lasse ich sie mir erklären, prüfe die Erklärung nach oder schreibe die Stelle neu. Es gibt keinen Rabatt für Code, nur weil er schnell entstanden ist.
Die KI-Reviews nutze ich trotzdem, und zwar gern. Ein zweites Modell, das gezielt nach Fehlern sucht, findet oft Dinge, die ich übersehen hätte: einen vergessenen Randfall, eine Variable, die nie benutzt wird, eine Abfrage, die bei leeren Daten auf die Nase fällt. Das ist eine echte Hilfe. Aber es ist ein Filter vor meinem Review und kein Ersatz dafür. Die Hinweise der KI lese ich wie die Anmerkungen eines Kollegen: ernst nehmen, nachprüfen, selbst entscheiden.
Mir ist bewusst, dass das nicht in jedem Umfeld so einfach geht. Wer in einem großen Team unter Zeitdruck arbeitet, hat vielleicht nicht immer die Ruhe dafür. Aber gerade dort halte ich es für wichtig, sich diese Zeit bewusst zu nehmen, statt sie stillschweigend wegfallen zu lassen.
Was sonst noch hilft
Neben dem gründlichen Lesen haben sich für mich ein paar Dinge bewährt, die das Review überhaupt erst machbar halten.
Kleinere Änderungen. Die Versuchung ist groß, die KI gleich ein ganzes Modul umbauen zu lassen. Besser ist es, in kleinen Schritten zu arbeiten, die man noch überblicken kann. Ein Pull Request mit fünfzig geänderten Zeilen lässt sich ernsthaft prüfen. Einer mit zweitausend nicht, da kann man sich noch so viel vornehmen.
Tests zuerst, oder zumindest Tests ernst nehmen. Generierte Tests sind ein zweischneidiges Schwert. Wenn dieselbe KI den Code und die Tests schreibt, testen die Tests oft genau das, was der Code tut, und nicht das, was er tun soll. Ich schreibe deshalb gern zuerst auf, was ich erwarte, und lasse dann den Code dazu erzeugen. Oder ich prüfe zumindest die Tests genauso kritisch wie den eigentlichen Code. Ein grüner Test, der das Falsche prüft, ist schlimmer als gar keiner, weil er falsche Sicherheit gibt.
Automatische Prüfungen als erste Instanz. Linter, statische Analyse, Architekturregeln, die maschinell durchgesetzt werden. All das entlastet das menschliche Review, weil die mechanischen Fehler schon vorher abgefangen werden. Ich muss mich dann nicht mehr mit fehlenden Leerzeichen beschäftigen, sondern kann mich auf die Fragen konzentrieren, die wirklich Urteilsvermögen brauchen.
Bewusst ablehnen. Man muss sich erlauben, generierten Code wegzuwerfen, auch wenn er funktioniert. Wenn er nicht zur Architektur passt, wenn er zu kompliziert ist, wenn man ihn nicht versteht. Der Code hat ja fast nichts gekostet. Das Weiterarbeiten mit schlechtem Code kostet dagegen sehr viel, und zwar jeden Tag ein bisschen.
Warum ein automatischer Freigabeprozess nicht unser Ziel sein kann
Der nächste Gedanke liegt nahe, und ich höre ihn immer öfter. Wenn eine KI den Code schreibt und eine zweite ihn prüft, warum dann nicht gleich auch die Freigabe automatisieren? Ein Modell schreibt, eines prüft, die Pipeline merged. Engpass weg. Technisch ist das längst machbar, und ich verstehe den Reiz. Es wäre schneller, billiger und auf den ersten Blick sogar konsequent.
Ich halte es trotzdem für das falsche Ziel. Und zwar auch dann, wenn ein automatisches Review irgendwann auf einem ähnlichen Niveau arbeitet wie ein erfahrener Mensch. Selbst wenn es genauso viele Fehler findet, fehlt etwas Entscheidendes.
Ein gutes Review ist mehr als Fehlersuche. Es braucht Feingefühl. Man merkt, dass eine Lösung zwar korrekt ist, aber nicht zum Team passt. Dass eine Kollegin an genau dieser Stelle gerade etwas anderes plant. Dass eine Abkürzung hier vertretbar ist, weil das Modul nächsten Monat ohnehin neu gebaut wird, und dort eben nicht. Dass ein Kunde bei einer bestimmten Funktion besonders empfindlich reagiert, weil es da schon einmal Ärger gab. Das sind Einschätzungen, oft ganz subjektive. Sie kommen aus Erfahrung, aus Gesprächen in der Kaffeeküche, aus dem Wissen über Menschen und Pläne, das in keinem Repository steht und in keiner Dokumentation.
Subjektiv ist dabei kein Makel. Gerade die Frage, ob sich etwas richtig anfühlt, ob es lesbar ist, ob man es in einem Jahr noch gern anfasst, lässt sich nicht vollständig in Regeln gießen. Ein Mensch kann sagen: Das funktioniert, aber so wollen wir das hier nicht machen. Und er kann begründen, warum, auch wenn die Begründung manchmal einfach Erfahrung heißt.
Verantwortung lässt sich nicht delegieren
Und dann ist da noch der Punkt, der für mich den Ausschlag gibt: die Verantwortung. Wer einen Pull Request freigibt, sagt damit: Dafür stehe ich ein. Das ist eine Garantie, kein Häkchen in einem Formular.
Wenn es nachts in Produktion knallt, gibt es jemanden, der erklären kann, warum das so durchgegangen ist, und der dafür geradesteht. Jemanden, der dem Kunden gegenübertritt, der die Ursache sucht und der daraus etwas für das nächste Mal mitnimmt. Diese Garantie kann eine KI nicht geben. Sie haftet nicht, sie muss sich niemandem erklären, und sie trägt die Folgen nicht. Selbst das beste Modell gibt am Ende eine Wahrscheinlichkeit ab, keine Zusage.
Eine Freigabe ohne Mensch ist deshalb keine Freigabe. Es ist ein grüner Haken. Und ein grüner Haken ist genau so viel wert wie die Prüfung, die dahintersteht, und die Person, die dafür einsteht.
Es gibt noch einen leiseren Grund. Wer das Review abgibt, verliert mit der Zeit den Überblick über das eigene System. Man weiß dann nicht mehr, wie bestimmte Teile funktionieren, weil man sie nie wirklich gelesen hat. Spätestens wenn etwas schiefgeht und schnell gehandelt werden muss, rächt sich das. Das Review ist für mich deshalb auch eine Art, mein Projekt zu kennen. Jede Zeile, die ich gelesen habe, ist eine Zeile, die mich später nicht überrascht.
Die KI darf also gern vorsortieren, Hinweise geben und mir Arbeit abnehmen. Die letzte Entscheidung und die Unterschrift darunter gehören einem Menschen. In meinen Projekten bin das ich.
Wartbarkeit ist eine Haltung
Am Ende geht es bei Codequalität weniger um Werkzeuge als um eine Haltung. Die Frage ist, wem der Code gehört. Wenn ich generierten Code in ein Projekt übernehme oder freigebe, ist es mein Code. Ich muss ihn verstehen, ich muss ihn in einem Jahr noch warten können, ich muss ihn erklären können, wenn jemand fragt.
Das klingt selbstverständlich, aber der Alltag sieht oft anders aus. Unter Zeitdruck ist es sehr bequem, sich auf die Maschine zu verlassen. Die eigentliche Disziplin besteht darin, die gewonnene Zeit nicht einfach in noch mehr Features zu stecken, sondern einen Teil davon in Verständnis, Review und Aufräumen.
Ich sehe das inzwischen so: Die KI hat mir das Tippen abgenommen, nicht das Denken. Die Zeit, die ich beim Schreiben spare, investiere ich zu einem guten Teil ins Lesen. Unterm Strich bin ich trotzdem schneller als früher, und ich weiß dabei immer noch, was in meinem Code passiert.
Wer das schafft, für den sind KI-Assistenten ein echter Gewinn. Wer es nicht schafft, wird in ein paar Jahren vor einer Codebasis sitzen, die sehr ordentlich aussieht und die trotzdem niemand mehr versteht. Und bei der im Ernstfall niemand sagen kann, wer sie eigentlich freigegeben hat.
Christian Ackermann
Softwareentwickler (C++, C, Java, C#) aus der Oberpfalz, bloggt seit 2001 über Linux, Technik und Kochen.