Alte Borland-C++Builder-Projekte modernisieren: Die Unicode-Falle
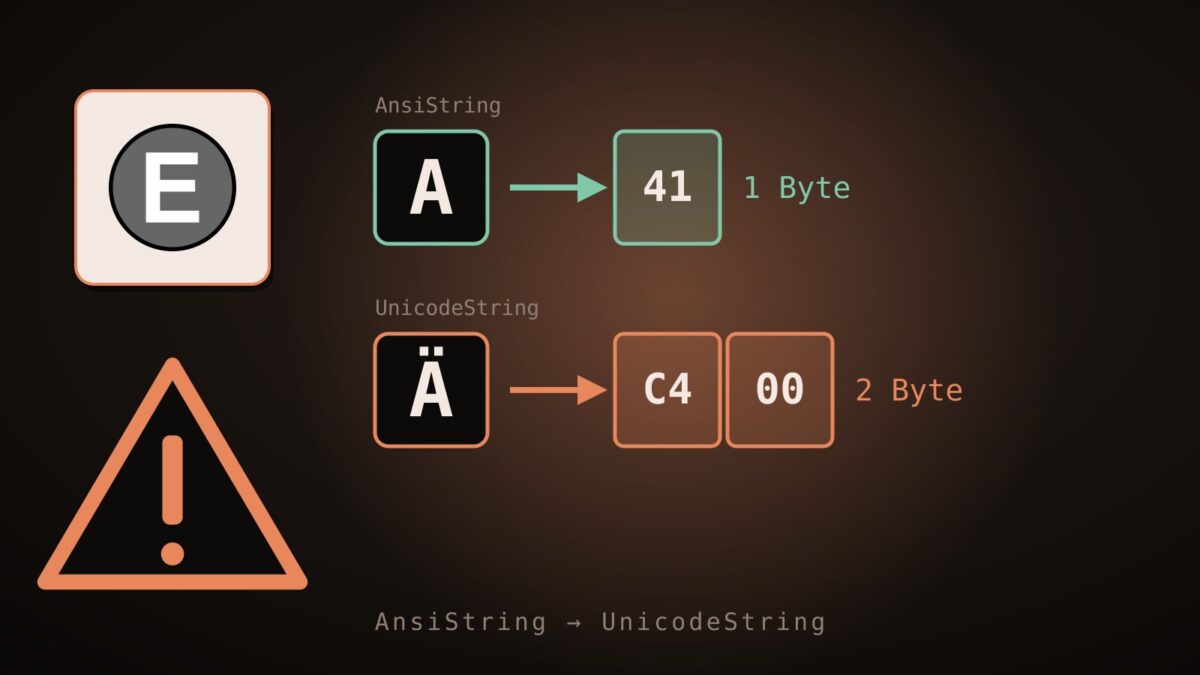
Keine Zeit? Hier die Kurzversion in 30 Sekunden.
- Seit C++Builder 2009 ist
StringeinUnicodeString(UTF-16,wchar_t), vorher war es einAnsiString.- Die meisten Compilerfehler beim Umzug von BCB 5/6 auf XE/XE2 kommen von
c_str(), das jetztwchar_t*liefert, und von WinAPI-Aufrufen mitchar-Puffern.- Gefährlicher sind die Stellen, die ohne Fehlermeldung kompilieren: Dateiformate, Streams und Schnittstellen, die Bytes erwarten.
- Dort gehört explizit
AnsiStringoder einTEncodinghin, nicht ein blindes Umstellen auf Unicode.- Migrieren lohnt sich, wenn die Software noch weiterentwickelt wird. Ein stabiles Altprojekt kann man auch ruhen lassen.
Wer ein altes Projekt aus der Borland-Zeit besitzt, also C++Builder 5 oder 6, und es auf eine aktuelle Version bringen will, landet früher oder später bei derselben Frage: Was ist eigentlich mit den Strings passiert? Seit C++Builder 2009 ist String nicht mehr ein Alias für AnsiString, sondern für UnicodeString. Intern liegen die Zeichen als UTF-16 vor, der Zeichentyp ist wchar_t. Das ist für neue Programme eine gute Entscheidung, für alten Code aber die größte Hürde beim Umzug auf C++Builder XE oder XE2. Ich habe mir das an ein paar kleineren Projekten angesehen und möchte die Stellen sammeln, an denen es regelmäßig knallt.
Was sich geändert hat
Vor 2009 war ein String ein Byte-Puffer in der jeweiligen Windows-Codepage. Length() war gleichzeitig die Anzahl der Zeichen und die Anzahl der Bytes, und c_str() lieferte einen char*. Das hat man jahrelang gedankenlos ausgenutzt. Jetzt sind es zwei Bytes pro Zeichen, c_str() liefert const wchar_t*, und alles, was Bytes und Zeichen verwechselt, ist falsch. AnsiString gibt es weiterhin, und genau das ist das Werkzeug für die Migration: Man muss an jeder Stelle entscheiden, ob dort Text gemeint ist (dann String) oder eine Folge von Bytes in einer bestimmten Codierung (dann AnsiString oder ein Encoding).
WinAPI und die A/W-Frage
Der erste Schwung Fehler kommt von der Windows-API. Funktionen wie GetWindowsDirectory oder MessageBox gibt es als A-Variante (char) und als W-Variante (wchar_t), und das Makro ohne Suffix wählt je nach Projekteinstellung eine davon. Seit 2009 wird standardmäßig die Unicode-Variante genommen, _TCHAR bedeutet also wchar_t. In den Projektoptionen lässt sich das zwar umstellen, aber das ist eine Notlösung, die die Probleme nur verschiebt. Ein typischer Fall:
// alt (BCB 6)
char buf[MAX_PATH];
GetWindowsDirectory(buf, MAX_PATH);
String dir = buf;
Mit XE kompiliert das nicht mehr, weil GetWindowsDirectory jetzt GetWindowsDirectoryW ist und einen wchar_t* erwartet. Die Lösung ist, den Puffer als TCHAR anzulegen, dann stimmt es unabhängig vom Mapping:
// neu
TCHAR buf[MAX_PATH];
GetWindowsDirectory(buf, MAX_PATH);
String dir = buf;
Ähnlich bei Dialogen: MessageBox(Handle, s.c_str(), "Titel", MB_OK) scheitert, weil das Literal "Titel" ein char-Literal ist. Entweder schreibt man L"Titel" oder nutzt _T("Titel"). Wer eine API wirklich nur in der A-Variante braucht, ruft sie ausdrücklich auf (MessageBoxA) und übergibt einen AnsiString. Das sollte aber die Ausnahme sein.
Die stillen Fehler
Unangenehmer sind die Stellen, die ohne Fehler durchlaufen. Wer zum Beispiel eine Datei mit der C-Bibliothek schreibt, hat früher so etwas gehabt:
FILE *f = fopen("daten.txt", "wb");
fwrite(s.c_str(), 1, s.Length(), f);
Mit UnicodeString lässt sich das kompilieren (c_str() wird zu const void*), schreibt aber nur die Hälfte der Bytes, nämlich Length() statt Length() * 2, und die zudem als UTF-16. Das Ergebnis ist eine Datei, die kein anderes Programm mehr versteht. Hier muss man sich entscheiden, was in der Datei stehen soll. Wenn das Format ANSI vorschreibt, weil es etwa eine bestehende Schnittstelle gibt, dann konvertiert man ausdrücklich:
AnsiString a = s;   // Konvertierung in die ANSI-Codepage
fwrite(a.c_str(), 1, a.Length(), f);
Dabei gehen Zeichen verloren, die in der Codepage nicht vorkommen. Das ist bei einem reinen Altformat hinnehmbar, sollte aber eine bewusste Entscheidung sein. Dasselbe gilt für Sockets, serielle Schnittstellen, Datenbankfelder und alles, was ein Protokoll mit festen Byte-Längen spricht. Auch sizeof und memcpy auf Strings oder Records mit String-Feldern lohnen einen zweiten Blick.
Textdateien und TStringList
Bei TStringList ist es einfacher geworden, weil SaveToFile und LoadFromFile einen Encoding-Parameter haben:
TStringList *liste = new TStringList;
try {
    liste->LoadFromFile("alt.txt", TEncoding::Default);   // ANSI-Codepage
    liste->SaveToFile("neu.txt", TEncoding::UTF8);
}
__finally {
    delete liste;
}
Ohne Angabe wird beim Speichern die ANSI-Codepage verwendet, beim Laden versucht die Klasse, anhand einer Signatur (BOM) zu erkennen, was vorliegt. Für Dateien ohne BOM sollte man das Encoding selbst festlegen. Ich würde Konfigurationsdateien, die das Programm allein liest, auf UTF-8 umstellen und bei Fremdformaten bei dem bleiben, was die Gegenseite erwartet.
Als weitere Altlast steckt in vielen alten Projekten noch die BDE, die Borland Database Engine. Sie wird nicht mehr weiterentwickelt, und wer sie ablösen muss, hat damit ein eigenes Projekt. Das hat mit Unicode nur am Rande zu tun, kommt aber meistens zeitgleich auf den Tisch.
Migrieren oder alt lassen?
Für das Migrieren spricht, dass ein modernes Programm mit Unicode-Strings keine Probleme mit Umlauten, fremden Zeichensätzen oder Pfaden außerhalb der Codepage hat. Dazu kommt, dass die alten Compiler auf aktuellen Windows-Versionen irgendwann unbequem werden und Komponenten von Drittanbietern oft nur noch für neue Versionen gepflegt werden. Wer die Software noch aktiv weiterentwickelt, spart sich mit dem Umzug langfristig Ärger.
Dagegen spricht der Aufwand, der sich vorher schwer abschätzen lässt. Der Compiler zeigt nur einen Teil der Stellen an, den Rest findet man durch Testen mit Sonderzeichen und mit den echten Dateien aus dem Betrieb. Außerdem fehlt manchmal der Quellcode einer Komponente, und dann ist die Migration an dieser Stelle zu Ende. Ein Programm, das stabil läuft, nur deutsche Texte verarbeitet und nicht mehr erweitert wird, muss nicht zwingend umgestellt werden.
Meine Meinung: Wenn das Projekt noch ein paar Jahre leben soll, lieber jetzt und in kleinen Schritten migrieren, als später in einem Rutsch. Zuerst alles zum Kompilieren bringen, dann gezielt nach den stillen Fehlern suchen, dabei Schnittstellen und Dateiformate dokumentieren, und erst am Schluss darüber nachdenken, ob man etwas auf UTF-8 umstellt.
Beitragsbild: eigene Collage mit Logos von Wikimedia Commons (Embarcadero-Logo: Jc86035, CC BY-SA 3.0); die Marken gehören ihren Inhabern. Die Collage steht ebenfalls unter CC BY-SA 3.0.

Christian Ackermann
Softwareentwickler (C++, C, Java, C#) aus der Oberpfalz, bloggt seit 2001 über Linux, Technik und Kochen.