JPA 2 Criteria API: typsicher, aber lesbar?
Keine Zeit? Hier die Kurzversion in 30 Sekunden.
- Die Criteria API aus JPA 2.0 baut Abfragen per Java-Code (
CriteriaBuilder,CriteriaQuery,Root,Predicate) statt per JPQL-String.- Mit dem Metamodell (
Kunde_.name, erzeugt per Annotation Processor, z. B. hibernate-jpamodelgen) merkt schon der Compiler, wenn ein Attribut nicht mehr existiert.- Stark ist die Criteria API bei dynamischen Suchmasken mit optionalen Filtern.
- Bei festen Abfragen ist ein JPQL-String deutlich kürzer und lesbarer.
- Meine Praxis: JPQL als Standard, Criteria nur dort, wo die Abfrage zur Laufzeit zusammengebaut wird.
Mit JPA 2.0, das mit Java EE 6 kam und sich auch ohne Application Server mit Hibernate oder EclipseLink nutzen lässt, gibt es neben JPQL eine zweite Möglichkeit, Abfragen zu formulieren: die Criteria API. Ich habe sie in den letzten Wochen in ein paar kleineren Projekten eingesetzt und bin ziemlich geteilter Meinung. Sie löst ein echtes Problem, produziert aber Code, den man erst einmal lesen können muss.
Das Problem mit Strings
Eine JPQL-Abfrage ist ein String:
List<Kunde> kunden = em.createQuery(
        "select k from Kunde k where k.ort = :ort order by k.name", Kunde.class)
    .setParameter("ort", "Hamburg")
    .getResultList();
Das ist kurz und ähnelt SQL, jeder versteht es sofort. Der Nachteil: Der Compiler sieht nur einen String. Ein Tippfehler bei k.ort oder ein umbenanntes Attribut fällt erst zur Laufzeit auf, wenn die Abfrage zum ersten Mal ausgeführt wird. Mit Named Queries wird das wenigstens beim Start der Persistence-Einheit geprüft, aber auch das ist kein Compilerfehler. Und sobald die Abfrage dynamisch wird, also je nach Eingabe Bedingungen hinzukommen oder wegfallen, endet man bei StringBuilder, bei dem man auf Leerzeichen und and/where achten muss. Das ist fehleranfällig und sieht schnell hässlich aus.
Die gleiche Abfrage mit Criteria
Als Criteria-Abfrage sieht das so aus:
CriteriaBuilder cb = em.getCriteriaBuilder();
CriteriaQuery<Kunde> cq = cb.createQuery(Kunde.class);
Root<Kunde> k = cq.from(Kunde.class);
cq.select(k)
  .where(cb.equal(k.get(Kunde_.ort), "Hamburg"))
  .orderBy(cb.asc(k.get(Kunde_.name)));
List<Kunde> kunden = em.createQuery(cq).getResultList();
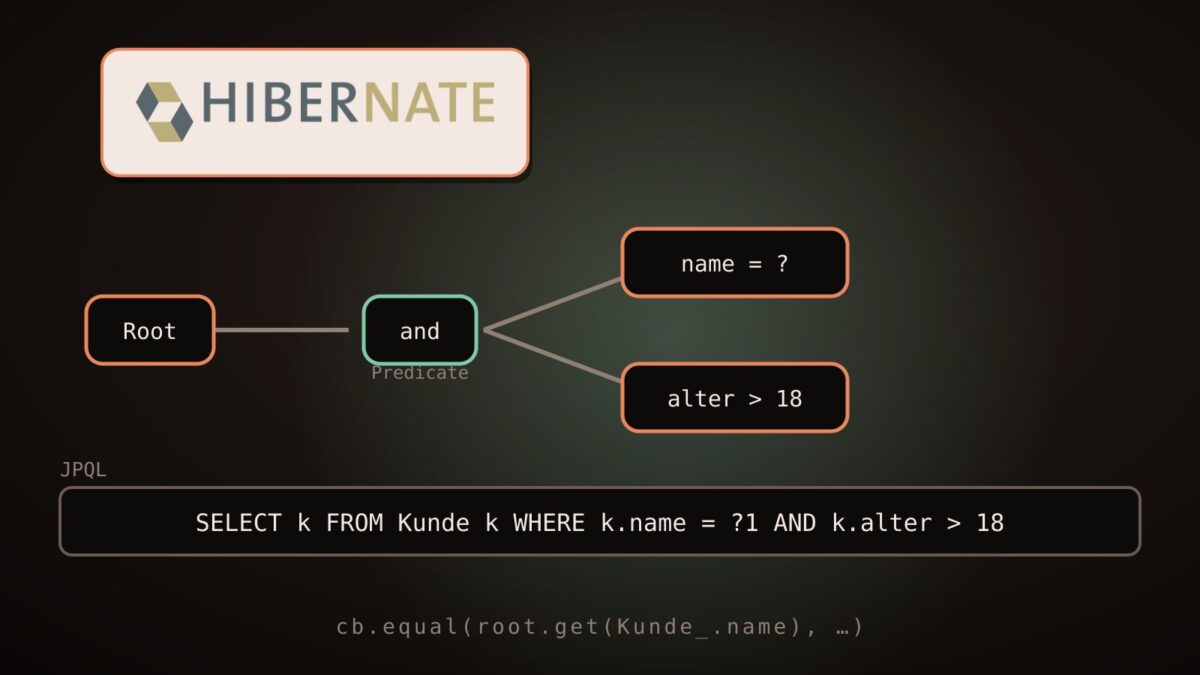
Der CriteriaBuilder ist die Fabrik für alles, CriteriaQuery beschreibt die Abfrage, Root steht für die Entität in der from-Klausel, und die einzelnen Bedingungen sind Predicate-Objekte. Das ist mehr als doppelt so viel Code wie vorher, und wer SQL gewohnt ist, muss die Struktur erst einmal im Kopf zurückübersetzen. Bei festen Abfragen halte ich das für keinen Gewinn.
Das Metamodell
Der eigentliche Nutzen entsteht durch das Metamodell. Zu jeder Entität gibt es eine generierte Klasse mit dem Unterstrich am Ende, in der jedes Attribut als statisches Feld steht:
@StaticMetamodel(Kunde.class)
public abstract class Kunde_ {
    public static volatile SingularAttribute<Kunde, String> name;
    public static volatile SingularAttribute<Kunde, String> ort;
}
Man schreibt diese Klassen nicht von Hand. Hibernate bringt dafür hibernate-jpamodelgen mit, ein Annotation Processor, der beim Kompilieren läuft. Mit Maven reicht es, die Bibliothek als Abhängigkeit in der Phase provided einzutragen, und javac findet den Processor ab Java 6 von selbst. In Eclipse muss man das Annotation Processing im Projekt einschalten und den generierten Ordner als Quellordner eintragen, sonst fehlen die _-Klassen in der IDE, obwohl der Build funktioniert. Das hat mich anfangs einigen Nerv gekostet.
Dafür bekommt man k.get(Kunde_.ort) mit Typprüfung: Wird das Attribut umbenannt oder entfernt, bricht die Kompilierung ab, und bei cb.equal oder cb.like merkt der Compiler, wenn der Typ nicht passt. Es gibt auch die Variante k.get("ort") ohne Metamodell, aber dann hat man den Vorteil verschenkt und ist wieder bei Strings.
Dynamische Filter: wo die Criteria API glänzt
Richtig sinnvoll wird es bei Suchmasken, in denen der Benutzer beliebige Felder ausfüllen kann:
public List<Kunde> suche(String name, String ort) {
    CriteriaBuilder cb = em.getCriteriaBuilder();
    CriteriaQuery<Kunde> cq = cb.createQuery(Kunde.class);
    Root<Kunde> k = cq.from(Kunde.class);

    List<Predicate> filter = new ArrayList<Predicate>();
    if (name != null && name.length() > 0) {
        filter.add(cb.like(cb.lower(k.get(Kunde_.name)),
                           name.toLowerCase() + "%"));
    }
    if (ort != null && ort.length() > 0) {
        filter.add(cb.equal(k.get(Kunde_.ort), ort));
    }

    cq.select(k)
      .where(filter.toArray(new Predicate[filter.size()]))
      .orderBy(cb.asc(k.get(Kunde_.name)));
    return em.createQuery(cq).getResultList();
}
Die Liste der Predicate-Objekte wird einfach nach Bedarf gefüllt, und where verknüpft sie mit and. Kein String-Gefummel, keine Parameter, die man von Hand benennen muss, und die Eingaben landen automatisch als Bind-Parameter in der Abfrage. Genau dafür ist die API gemacht. Auch Joins (k.join(Kunde_.bestellungen)) lassen sich bedingt hinzufügen, und eine Methode, die einzelne Prädikate liefert, lässt sich gut testen und wiederverwenden.
Wo es hakt
Ein paar Dinge fallen im Alltag auf. Zum einen sind die Generics lang: SingularAttribute<Kunde, String>, Root<Kunde>, CriteriaQuery<Kunde>, und bei Joins oder Unterabfragen wird die Typangabe schnell unhandlich. Mit Java 7 hilft der Diamond-Operator an einigen Stellen, aber nicht bei allem. Zum anderen gibt es Eigenheiten, die man nur durch Ausprobieren lernt: Vergleiche mit null müssen über isNull laufen, Aggregatfunktionen und group by verlangen eine andere Form von CriteriaQuery (etwa mit Tuple oder Object[]), und die Fehlermeldungen bei falsch verschachtelten Prädikaten sind nicht besonders hilfreich. Dazu kommt, dass die Implementierungen die Spezifikation nicht in jedem Randfall gleich umsetzen, was bei JPQL im Alltag selten auffällt.
Man sollte außerdem ehrlich bleiben, was die Typsicherheit bringt. Sie schützt vor falsch geschriebenen Attributnamen und falschen Typen, nicht vor falscher Logik. Eine Abfrage, die syntaktisch einwandfrei ist und trotzdem das Falsche liefert, bekommt man mit der Criteria API genauso hin. Ein Test, der die Suche mit ein paar Datensätzen durchspielt, bleibt unverzichtbar, egal welche Variante man wählt.
Meine Einschätzung
Die Criteria API ist kein Ersatz für JPQL, sondern eine Ergänzung. Für feste Abfragen mit zwei, drei Bedingungen ist der JPQL-String besser: kürzer, näher an SQL, und man sieht auf einen Blick, was passiert. Der Vorteil der Typsicherheit wiegt das bei so einfachen Abfragen nicht auf, vor allem, wenn man Integrationstests hat, die die Abfragen ohnehin ausführen. Bei dynamischen Abfragen sieht es umgekehrt aus. Dort ist der String-Zusammenbau schlechter lesbar als die Criteria-Variante, und das Metamodell bringt Sicherheit bei Umbenennungen.
Aufwand und Lesbarkeit entscheiden letztlich, ob sich die Criteria API für ein Projekt lohnt. Ich fange meist mit JPQL an und steige erst auf Criteria um, wenn eine Abfrage wirklich zur Laufzeit zusammengesetzt werden muss. Dann lege ich die Filter in eine eigene Klasse, damit die Suchmaske selbst nicht von CriteriaBuilder-Aufrufen überladen wird.
Beitragsbild: eigene Collage mit Logos von Wikimedia Commons (Hibernate-Logo: Red Hat, gemeinfrei); die Marken gehören ihren Inhabern.

Christian Ackermann
Softwareentwickler (C++, C, Java, C#) aus der Oberpfalz, bloggt seit 2001 über Linux, Technik und Kochen.