Docker 1.0: Java-Anwendungen im Container
Keine Zeit? Hier die Kurzversion in 30 Sekunden.
- Docker 1.0 ist seit Juni 2014 draußen und wird als produktionsreif bezeichnet; ein Container ist kein virtueller Rechner, sondern ein isolierter Prozess auf dem Host-Kernel.
- Eine Spring-Boot-Fat-JAR passt gut: Ein Dockerfile mit Basis-Image, Java-Laufzeit,
EXPOSEundCMD java -jargenügt.- Images bestehen aus Schichten (Layers) und lassen sich über den Docker Hub teilen.
- Die JVM liest den Speicher des Hosts, nicht die Grenze des Containers. Den Heap daher immer mit
-Xmxselbst setzen.- Grenzen heute: nur Linux, Isolation noch Diskussionsthema, Orchestrierung ungelöst.
Im Juni, auf der DockerCon, wurde Docker 1.0 veröffentlicht. Ich habe das Thema eine Weile nur aus der Ferne beobachtet, weil mir die Beschreibungen zu sehr nach Werbung klangen. Jetzt habe ich es mit einer kleinen Spring-Boot-Anwendung ausprobiert, und ich muss zugeben: Es ist weniger Magie, als der Wirbel vermuten lässt, und gerade deshalb brauchbar.
Container sind keine virtuellen Maschinen
Eine virtuelle Maschine bringt ein komplettes Betriebssystem samt Kernel mit. Ein Docker-Container teilt sich den Kernel des Hosts und läuft als normaler Prozess, nur eben mit eigener Sicht auf Dateisystem, Prozessliste und Netzwerk. Dahinter stecken Funktionen des Linux-Kernels (Namespaces und Control Groups), die es schon länger gibt. Neu ist vor allem, wie bequem Docker sie verpackt.
Die praktische Folge: Ein Container startet in Sekundenbruchteilen, weil kein Betriebssystem bootet, und er braucht kaum Overhead. Die Kehrseite ist, dass die Trennung weniger hart ist als bei einer VM. Wer fremden Code nicht vertraut, sollte sich nicht allein auf Container verlassen. Die Sicherheitsdiskussion läuft gerade und ist noch nicht abgeschlossen, ich würde Docker deshalb nicht für Mandantentrennung zwischen Fremden einsetzen.
Das Dockerfile
Als Beispiel dient eine Spring-Boot-Anwendung, die als eine einzige ausführbare JAR gebaut wird. Diese Fat-JAR bringt ihren eingebetteten Webserver mit, man braucht also keinen Anwendungsserver im Container. Das Dockerfile dazu:
FROM ubuntu:14.04
RUN apt-get update && apt-get install -y openjdk-7-jre-headless
ADD meineanwendung.jar /opt/app/meineanwendung.jar
EXPOSE 8080
CMD ["java", "-Xmx256m", "-jar", "/opt/app/meineanwendung.jar"]
FROM legt das Basis-Image fest. Ich nehme hier ein nacktes Ubuntu und installiere die Java-Laufzeit selbst; es gibt auch fertige Images mit Java, aber ob man denen vertraut und welche Version drinsteckt, muss man im Einzelfall prüfen. ADD kopiert die JAR ins Image, EXPOSE dokumentiert den Port, CMD ist der Startbefehl. Gebaut und gestartet wird so:
docker build -t meine/anwendung .
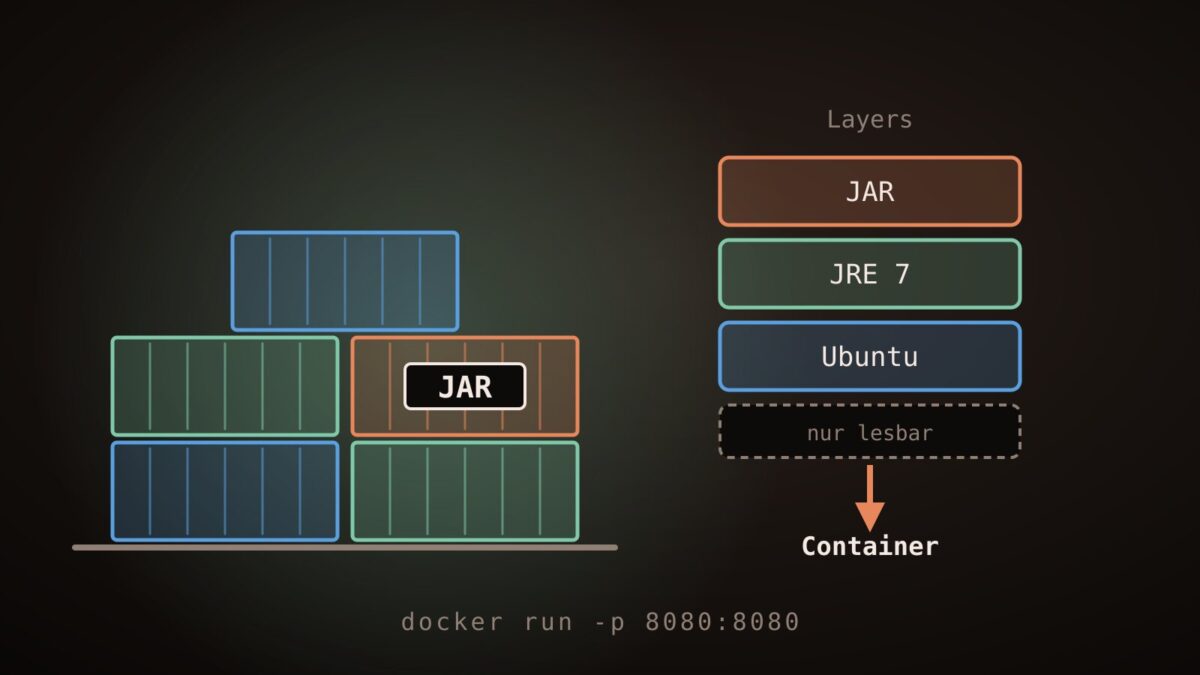
docker run -d -p 8080:8080 meine/anwendung
-p 8080:8080 verbindet den Port des Hosts mit dem des Containers. Danach ist die Anwendung unter dem Host erreichbar, als wäre sie dort gestartet worden. Dass das beim ersten Mal ohne Fummelei klappt, hat mich ehrlich beeindruckt.
Images, Schichten und der Hub
Jede Anweisung im Dockerfile erzeugt eine Schicht. Ändere ich nur die JAR, wird beim nächsten Build nur diese letzte Schicht neu erzeugt; Ubuntu und die Java-Installation kommen aus dem Cache. Das macht Builds schnell und spart Platz, weil sich mehrere Images dieselben unteren Schichten teilen. Deshalb steht im Dockerfile das, was sich selten ändert, weiter oben, und die JAR kommt möglichst spät.
Der Docker Hub ist die zentrale Ablage für Images. Man kann fertige Images herunterladen oder eigene hochladen. Für interne Anwendungen würde ich das nicht ungeprüft öffentlich nutzen, ein eigenes Repository ist machbar. Und bei fremden Images gilt, was für fremde Binärdateien immer gilt: Man sollte wissen, was drinsteckt.
Daten gehören nicht ins Image
Ein Container ist als Wegwerfobjekt gedacht. Stoppt man ihn und startet einen neuen aus demselben Image, sind alle Dateien weg, die er zwischenzeitlich geschrieben hat. Für Logs, hochgeladene Dateien oder eine eingebettete Datenbank ist das ungünstig. Dafür gibt es Volumes, also Verzeichnisse, die außerhalb des Container-Dateisystems liegen:
docker run -d -p 8080:8080 -v /srv/anwendung/daten:/var/daten meine/anwendungDie Anwendung schreibt nach /var/daten, tatsächlich landet es auf dem Host. Ich denke inzwischen, dass man diese Trennung früh sauber ziehen sollte: Das Image enthält Code und Laufzeit, alles Veränderliche liegt draußen. Wer das ignoriert, merkt es spätestens beim ersten Update.
Die JVM und der Speicher
Hier bin ich fast in eine Falle getappt. Man kann einem Container per docker run -m eine Speichergrenze mitgeben. Die Java-Laufzeit weiß davon aber nichts. Sie fragt das Betriebssystem nach dem physischen Speicher und bekommt den des Hosts genannt. Der Standard-Heap leitet sich daraus ab, und so kann die JVM mehr Speicher reservieren, als der Container darf. Das Ende vom Lied: Der Kernel beendet den Prozess, ohne dass in Java eine schöne OutOfMemoryError-Meldung auftaucht.
Die Gegenmaßnahme ist banal: -Xmx immer explizit setzen und mit Luft unter dem Container-Limit bleiben, denn zur JVM gehört neben dem Heap noch einiges mehr (Metadaten, Threads, native Speicherbereiche). Wie viel Reserve nötig ist, lässt sich nur messen. Ich vermute, dass dieses Thema noch ein paar Leuten Ärger machen wird.
Was 2014 noch fehlt
- Nur Linux. Unter Windows und Mac OS X läuft Docker in einer kleinen virtuellen Maschine, zum Beispiel über boot2docker. Das funktioniert für Entwicklung, fühlt sich aber nicht nach Zuhause an. Verzeichnisse mit dem Host zu teilen ist dort noch etwas zäh.
- Sicherheit. Siehe oben. Containerprozesse laufen standardmäßig als root, und ich würde sie so wenig wie möglich mit Rechten ausstatten.
- Orchestrierung. Ein Container ist einfach, zwanzig Container auf mehreren Rechnern sind es nicht. Wie man sie startet, verbindet und überwacht, ist offen. Es gibt erste Ansätze, aber nichts, worauf ich mich schon festlegen würde.
Lohnt sich der Aufwand? Für mich ja, vor allem wegen der Reproduzierbarkeit. Das Dockerfile beschreibt die Laufzeitumgebung als Text, den man ins Versionsverwaltungssystem legen kann. Das Argument „bei mir lief es noch“ wird dadurch schwächer. Für Java, wo die Laufzeit ohnehin plattformübergreifend ist, ist der Gewinn kleiner als bei PHP- oder C++-Anwendungen mit vielen Systemabhängigkeiten, aber ganz ohne Nutzen ist er nicht, schon weil die richtige JRE-Version und Systembibliotheken gleich mitgeliefert werden.
Ein weiterer Punkt, den ich überraschend fand: Der Build der Anwendung und der Build des Images sind zwei getrennte Schritte. Maven oder Gradle erzeugen die JAR, Docker verpackt sie nur. Das passt gut zu einem Ablauf, in dem ein Build-Server das fertige Image erzeugt und man auf dem Zielrechner nichts mehr installieren muss außer Docker selbst. Ob man das wirklich so lebt, hängt von der Umgebung ab, aber der Gedanke gefällt mir.
Ob Docker die Art verändert, wie wir Software betreiben, kann ich noch nicht beurteilen. Zum Ausprobieren ist es jetzt reif. Für kritische Produktivsysteme würde ich noch einige Monate zuschauen.
Christian Ackermann
Softwareentwickler (C++, C, Java, C#) aus der Oberpfalz, bloggt seit 2001 über Linux, Technik und Kochen.